
Sommaire
- Définir le budget temporel de la scène avant de développer le prompt
- Transformer l’échange en un découpage mesurable
- Utiliser une itération documentée sans la confondre avec un résultat testé
- Convertir le plan en clauses de prompt compactes
- Placer les coupes là où l’attention change
- Réserver une image finale nette
- Examiner la scène dans l’ordre chronologique
Un bref échange peut surcharger un prompt vidéo étonnamment vite. Deux répliques peuvent également nécessiter un plan d’ensemble, des expressions distinctes, une réaction de l’interlocuteur, un changement de caméra et une image finale exploitable. Si ces événements sont décrits ensemble sans ordre précis, la scène peut être claire à l’écrit, mais difficile à évaluer en vidéo.
La solution consiste à planifier le dialogue sous forme de temps visuels minutés. Ce guide consacré à SpicyChat AI se concentre sur cette tâche de microtemporisation plutôt que sur le processus de production plus large présenté dans le flux de travail de la conversation à la vidéo.
SpicyChat AI sert ici de référence pour la mise en scène des personnages ; la génération s’effectue généralement dans un service vidéo distinct. Considérez les codes temporels ci-dessous comme des spécifications transférables de planification et de contrôle, sauf si le générateur choisi prend explicitement en charge les commandes temporelles.
Définir le budget temporel de la scène avant de développer le prompt
Commencez par fixer quatre limites :
- Durée totale du clip
- Basculement émotionnel de la scène
- Positions fixes des interlocuteurs
- Image finale requise
Prenons cet échange non explicite tiré du guide des prompts Veo de Google DeepMind :
Campeur : « Je ne fais plus qu’un avec la nature ! »
Ours : « La nature préférerait que tu respectes un peu son espace personnel. »
Le guide de Google présente le cadrage et les mouvements de caméra comme des choix explicites dans le prompt. Il propose également un exemple d’action distinct sous la forme d’une séquence exacte se déroulant en huit secondes, ce qui fait de cette durée un cadre utile pour cet exercice de planification.
L’échange contient 11 mots prononcés : cinq dans la réplique du campeur et six dans celle de l’ours. Avec un rythme de planification initial de 2.5 mots par seconde, la durée minimale estimée de la parole est de 4.4 secondes :
11 words ÷ 2.5 words per second = 4.4 seconds
Il reste donc environ 3.6 secondes pour la composition d’ouverture, les réactions de l’interlocuteur, un changement de plan et le maintien de l’image finale. Il ne s’agit que d’un budget initial. Lisez ou enregistrez le dialogue au rythme émotionnel prévu, mesurez sa durée et remplacez l’estimation avant de verrouiller les intervalles. Une réponse pince-sans-rire, par exemple, peut demander plus d’espace que ne le permet un calcul neutre fondé sur le débit de parole.
Si la lecture mesurée ne tient pas dans la durée, raccourcissez le texte ou divisez la scène. Supprimer toutes les pauses est rarement une bonne solution : sans un temps de réaction de l’interlocuteur, deux répliques peuvent sembler déconnectées même si elles ne se chevauchent pas.
Lorsque vous choisissez un générateur vidéo par IA réservé aux adultes de 18 ans et plus, vérifiez ses limites documentées concernant la durée des clips, le dialogue ou l’audio, les images de référence, le cadrage et le contrôle de la caméra. Un plan avec codes temporels reste utile même lorsque ceux-ci doivent être mis en œuvre au moyen de plans séparés ou du montage plutôt que saisis directement.
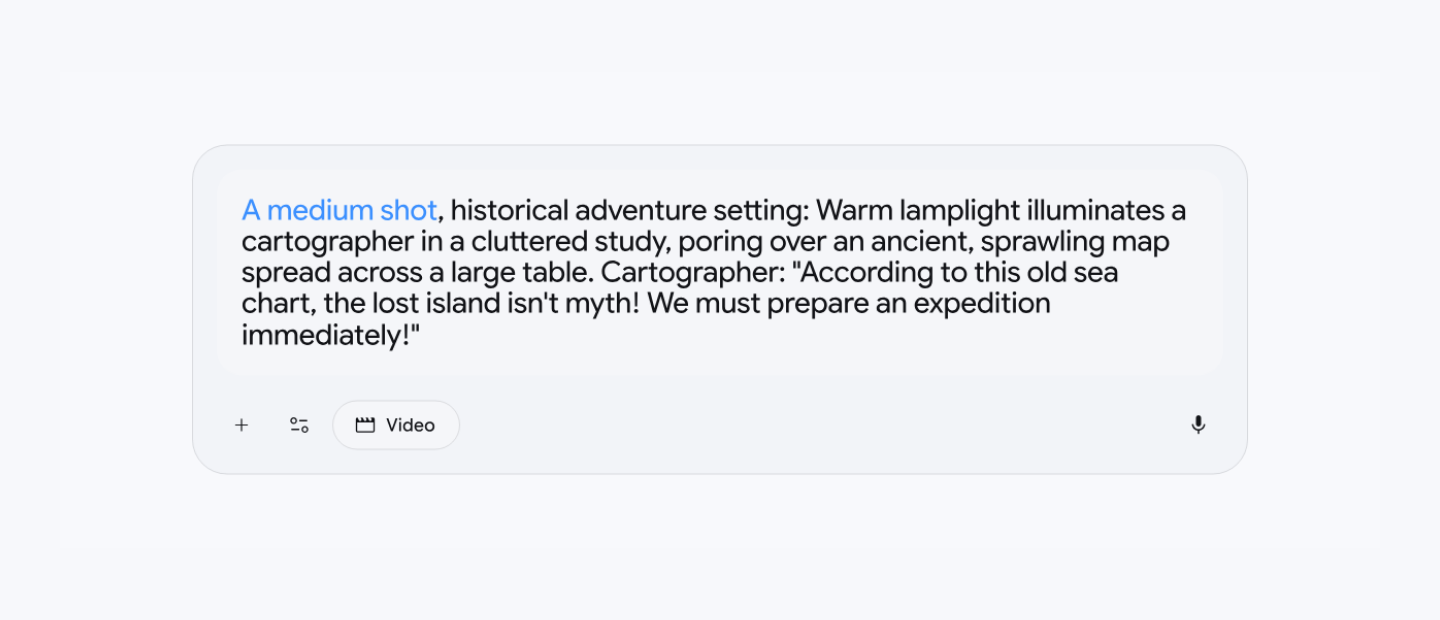
Le guide des prompts Veo place la taille du plan au début de la description de la scène, montrant ainsi que le cadrage constitue un choix explicite dans le prompt.
Transformer l’échange en un découpage mesurable
Attribuez un changement d’interprétation dominant à chaque intervalle. Un personnage peut parler tout en maintenant une pose, mais évitez de combiner simultanément une nouvelle expression, un geste de la main, une rotation du corps, un mouvement de caméra et la prononciation d’une réplique.
| Temps | Parole | Interprétation visible | Temps de réaction | État de la caméra | Critère d’acceptation |
|---|---|---|---|---|---|
| 0.0–0.6 s | Aucune | Le campeur conserve une expression satisfaite ; l’ours reste neutre | Maintien d’ouverture | Plan moyen fixe à deux personnages | Les deux personnages et leurs positions à l’écran sont clairement visibles |
| 0.6–2.4 s | Le campeur prononce la première réplique | Un petit geste de la main vers l’extérieur | L’ours reste immobile | La caméra reste fixe | Seul le campeur parle et gesticule |
| 2.4–3.0 s | Aucune | L’ours tourne les yeux vers le campeur | Réaction de l’interlocuteur de 0.6 seconde | Maintien du plan à deux | La réaction commence après la fin de la réplique |
| 3.0–5.6 s | L’ours prononce sa réponse | L’ours adopte une expression pince-sans-rire et peu impressionnée | Le campeur garde sa position | Coupe vers un plan moyen privilégiant l’ours | La coupe correspond au passage de parole |
| 5.6–6.3 s | Aucune | Le sourire du campeur se crispe légèrement | Réaction de 0.7 seconde | Aucun nouveau mouvement de caméra | Le campeur réagit sans ajouter de geste |
| 6.3–8.0 s | Aucune | Tous deux conservent leur expression stabilisée | Maintien final de 1.7 seconde | Composition stable | Aucune parole, coupe ou nouveau mouvement ne survient avant la fin |
Les fenêtres de parole totalisent 4.4 secondes, ce qui correspond à l’estimation préliminaire fondée sur le débit verbal. Elles doivent néanmoins être révisées après avoir chronométré une véritable lecture. Si la réplique de l’ours dure trois secondes, par exemple, le tableau doit céder du temps ailleurs ou prévoir un clip plus long ; il ne faut pas simplement forcer la voix à tenir dans un intervalle plus court.
La durée des pauses constitue une valeur de planification ajustable, et non un paramètre universel du modèle. Son intérêt est de rendre chaque réaction contrôlable. « Marquer une brève pause » n’offre aucune limite fiable. « L’ours reste immobile jusqu’à 2.4 secondes, puis tourne les yeux pendant 0.6 seconde » précise le sujet, le minutage, le changement visible et l’état de la caméra.
Utilisez également des désignations stables pour les sujets. Définissez une fois « campeur à gauche du cadre » et « ours à droite du cadre », puis répétez ces désignations. Alterner entre « le campeur », « le voyageur », « il » et « le premier personnage » introduit une ambiguïté évitable.
Utiliser une itération documentée sans la confondre avec un résultat testé
Le guide d’Adobe consacré aux prompts vidéo efficaces présente un processus concret de perfectionnement en trois étapes pour une scène de mécha.
L’opération initiale consiste en un simple plan large, à hauteur des yeux, d’un mécha géant dans une rue. Le deuxième prompt comble les lacunes visibles de la spécification en ajoutant une armure jaune et orange, des rues désertes, des câbles, des LED et des éléments cybernétiques. La troisième itération ajoute des actions et des événements environnementaux distincts : le mécha marche, tire et effectue un balayage, tandis que les décombres, les incendies et une atmosphère menaçante définissent la scène environnante.
L’ajustement pratique est progressif plutôt que global. La position de la caméra et le sujet restent ancrés, tandis que les détails du personnage, l’environnement et l’action sont ajoutés lors de passages distincts. Le résultat documenté est un prompt final nettement plus précis, dont les composants peuvent être examinés individuellement ; Adobe ne publie pas de score comparatif des résultats pour les trois versions.
La même méthode améliore la planification des dialogues. Commencez par les deux interlocuteurs et une composition fixe. Ajoutez la première réplique. Ajoutez la réaction de l’interlocuteur. Ajoutez la réponse. N’ajoutez qu’un seul changement de plan motivé, puis réservez le maintien final. Si un temps échoue au contrôle, sa clause peut être révisée sans réécrire le personnage, le lieu, l’éclairage et toutes les autres actions.
Adobe recommande l’ordre « description du plan + personnage + action + lieu + esthétique ». L’entreprise conseille également des verbes concrets et des modificateurs de rythme tels que « lentement », « rapidement » et « progressivement ». Pour une scène minutée, associez ces termes à des limites observables : « se tourne lentement pendant 0.7 seconde » est plus facile à contrôler que « se tourne » ou « se tourne lentement ».
Convertir le plan en clauses de prompt compactes
Séparez les informations permanentes sur la scène des instructions d’interprétation chronologiques.
Mise en place de la scène
Camping en stop motion au crépuscule. Campeur à gauche du cadre ; ours à droite du cadre. Plan moyen à deux personnages, lumière chaude du feu, mouvements retenus, ton comique pince-sans-rire. Conserver l’apparence des personnages, leurs vêtements, la direction de l’éclairage et leurs positions à l’écran pendant toute la scène.
Interprétation minutée
0.0–0.6 : maintien d’ouverture fixe avec les deux personnages visibles. 0.6–2.4 : le campeur dit « Je ne fais plus qu’un avec la nature ! » en effectuant un petit geste de la main vers l’extérieur ; l’ours reste immobile. 2.4–3.0 : aucun dialogue ; l’ours tourne les yeux vers le campeur. À 3.0, coupe vers un plan moyen privilégiant l’ours. 3.0–5.6 : l’ours dit « La nature préférerait que tu respectes un peu son espace personnel » avec une expression retenue et peu impressionnée ; le campeur reste immobile. 5.6–6.3 : aucun dialogue ; le sourire du campeur se crispe légèrement. 6.3–8.0 : tous deux conservent leur expression finale ; caméra verrouillée ; aucune nouvelle parole ni aucun nouveau mouvement.
Cette structure permet de circonscrire les révisions. Une réaction prématurée de l’ours renvoie à la clause 2.4–3.0. Une réponse précipitée renvoie à l’intervalle 3.0–5.6. Aucun de ces problèmes n’exige de modifier le camping, le style visuel, les positions à l’écran ou le geste d’ouverture.
Si le générateur n’accepte pas les codes temporels, conservez la même séquence à l’aide de connecteurs explicites tels que « après que le campeur a fini de parler », « puis l’ours regarde le campeur » et « ce n’est qu’après cela que l’ours répond ». Pour un outil qui fonctionne mieux avec une seule action par génération, divisez le tableau en plans et assemblez-les au montage.
Placer les coupes là où l’attention change
Un changement de plan doit clarifier un événement narratif. Dans une courte scène dialoguée, les meilleurs points de coupe sont généralement :
- Un passage de parole
- Un renversement émotionnel
- Une révélation impossible à percevoir dans le cadrage actuel
Dans l’exemple, la coupe intervient lorsque l’ours commence à parler. L’attention se porte sur le nouvel interlocuteur sans interrompre la réplique du campeur ni masquer la première réaction de l’ours. Couper pendant le geste du campeur obligerait le spectateur à traiter simultanément une action physique et une nouvelle composition.
Une coupe n’est pas obligatoire. Les recommandations de Google pour Veo présentent le cadrage et les mouvements de caméra comme des décisions à intégrer au prompt, mais une caméra verrouillée peut communiquer le rythme des expressions faciales plus clairement qu’un panoramique, un zoom ou un mouvement orbital. Si la continuité est fragile, conservez le plan à deux et laissez l’interprétation assurer le passage de parole.
Les recettes de scènes pour SpicyChat AI offrent des recommandations plus générales pour adapter le cadrage et le risque lié aux mouvements à différents types de scènes. Choisissez-y la configuration générale, puis utilisez le découpage pour contrôler les événements au sein du plan.
Réserver une image finale nette
Ne terminez pas sur la dernière syllabe. Précisez une pose stabilisée, une expression, une composition, un état de caméra et une durée de maintien exploitable. Dans ce plan, les dernières 1.7 secondes ne comportent aucun dialogue, geste, coupe, zoom ou changement d’expression. Cet intervalle donne au monteur la possibilité de raccourcir le plan ou d’effectuer une transition sans s’arrêter sur une forme de bouche en mouvement.
La documentation vidéo de GenStudio d’Adobe présente, dans son flux de travail Firefly, des entrées pour la première et la dernière image ainsi que des réglages de taille de plan, d’angle de caméra et de référence de mouvement. Si le service choisi propose des commandes comparables, utilisez la référence finale pour renforcer la composition prévue. Dans le cas contraire, décrivez directement l’état final et laissez le temps au mouvement de se stabiliser.
Une spécification claire de la fin doit répondre à cinq questions :
- Qui reste visible ?
- Quelle expression chaque personnage conserve-t-il ?
- Les mains et le corps sont-ils immobiles ?
- La caméra est-elle verrouillée ?
- Combien de temps dure le maintien exploitable ?
« Terminer naturellement » ne répond à aucune de ces questions.
Examiner la scène dans l’ordre chronologique
Lisez le découpage de gauche à droite et arrêtez-vous au premier intervalle qui échoue. Vérifiez que :
- Le dialogue mesuré tient dans ses fenêtres de parole sans chevauchement.
- L’interlocuteur reste immobile jusqu’au temps de réaction indiqué.
- Chaque réaction modifie un seul élément visible plutôt que l’ensemble de l’interprétation.
- Les désignations des interlocuteurs et les positions à l’écran restent cohérentes.
- Chaque coupe correspond à un passage de parole, un renversement ou une révélation.
- Le mouvement de caméra ne rivalise pas avec le changement important d’expression faciale.
- La dernière pose se stabilise avant la fin du clip.
- Chaque instruction peut être jugée présente, absente, prématurée ou tardive.
Si le plan reste surchargé, supprimez un geste secondaire avant de supprimer la réaction de l’interlocuteur. S’il ne tient toujours pas, divisez-le en plans séparés. La mesure utile n’est pas le nombre d’instructions intégrées dans un prompt, mais le nombre de temps que le spectateur peut clairement percevoir.