
Inhalt
- Planen Sie das Zeitbudget der Szene, bevor Sie den Prompt erweitern
- Verwandeln Sie den Austausch in einen messbaren Ablaufplan
- Nutzen Sie dokumentierte Iterationen, ohne sie mit getesteten Ergebnissen zu verwechseln
- Überführen Sie den Plan in kompakte Prompt-Klauseln
- Setzen Sie Schnitte dort, wo sich die Aufmerksamkeit verlagert
- Reservieren Sie ein sauberes Schlussbild
- Prüfen Sie die Szene in chronologischer Reihenfolge
Ein kurzer Austausch kann einen Video-Prompt überraschend schnell überladen. Zwei gesprochene Sätze können zusätzlich eine eröffnende Einstellung, unterschiedliche Gesichtsausdrücke, eine Reaktion des Zuhörers, einen Kamerawechsel und ein brauchbares Schlussbild erfordern. Werden diese Ereignisse ohne Reihenfolge gemeinsam beschrieben, kann die Szene als Text verständlich, als Video jedoch schwer zu beurteilen sein.
Die Lösung besteht darin, den Dialog als zeitlich abgestimmte visuelle Phasen zu planen. Dieser Leitfaden zu SpicyChat AI konzentriert sich auf diese Aufgabe des Mikro-Timings und nicht auf die umfassendere Produktionspipeline, die im Workflow vom Chat zum Video behandelt wird.
SpicyChat AI dient hier als Referenz für die Inszenierung der Figuren; die Generierung erfolgt üblicherweise in einem separaten Videodienst. Behandeln Sie die folgenden Zeitstempel als übertragbare Planungs- und Prüfvorgaben, sofern der von Ihnen ausgewählte Generator zeitliche Steuerungen nicht ausdrücklich unterstützt.
Planen Sie das Zeitbudget der Szene, bevor Sie den Prompt erweitern
Legen Sie zunächst vier Grenzen fest:
- Gesamtdauer des Clips
- Emotionaler Wendepunkt der Szene
- Feste Positionen der Sprecher
- Erforderliches Schlussbild
Betrachten Sie diesen nicht expliziten Austausch aus dem Veo-Prompt-Leitfaden von Google DeepMind:
Camper: „Jetzt bin ich eins mit der Natur!“
Bär: „Die Natur hätte lieber etwas persönlichen Freiraum.“
Der Leitfaden von Google behandelt Bildgestaltung und Kamerabewegung als ausdrückliche Prompt-Entscheidungen. Außerdem präsentiert er ein separates Aktionsbeispiel als exakte Abfolge innerhalb von acht Sekunden, weshalb sich diese Dauer gut als Rahmen für diese Planungsübung eignet.
Der Austausch umfasst 11 gesprochene Wörter: fünf im Satz des Campers und sechs in dem des Bären. Bei einer anfänglichen Planungsrate von 2.5 Wörtern pro Sekunde beträgt die geschätzte Mindestsprechzeit 4.4 Sekunden:
11 words ÷ 2.5 words per second = 4.4 seconds
Damit bleiben schätzungsweise 3.6 Sekunden für die eröffnende Komposition, die Reaktionen des Zuhörers, einen Einstellungswechsel und das Halten des Schlussbilds. Dies ist lediglich ein anfängliches Zeitbudget. Lesen oder nehmen Sie den Dialog im vorgesehenen emotionalen Tempo auf, messen Sie ihn und ersetzen Sie die Schätzung, bevor Sie die Intervalle festlegen. Eine trockene Erwiderung kann beispielsweise mehr Raum benötigen, als eine neutrale Berechnung anhand der Wortzahl vorsieht.
Wenn die gemessene Lesung nicht hineinpasst, kürzen Sie den Wortlaut oder teilen Sie die Szene. Sämtliche Pausen zu entfernen, ist selten eine gute Lösung: Ohne eine Reaktionsphase des Zuhörers können zwei Sätze unverbunden wirken, selbst wenn sie sich nicht überschneiden.
Prüfen Sie bei der Auswahl eines KI-Videogenerators für Erwachsene ab 18 dessen dokumentierte Beschränkungen hinsichtlich Clipdauer, Dialog oder Audio, Referenzbildern, Bildgestaltung und Kamerasteuerung. Ein Plan mit Zeitcodes bleibt auch dann nützlich, wenn Zeitstempel mithilfe separater Einstellungen oder durch die Bearbeitung umgesetzt werden müssen, anstatt direkt eingegeben zu werden.
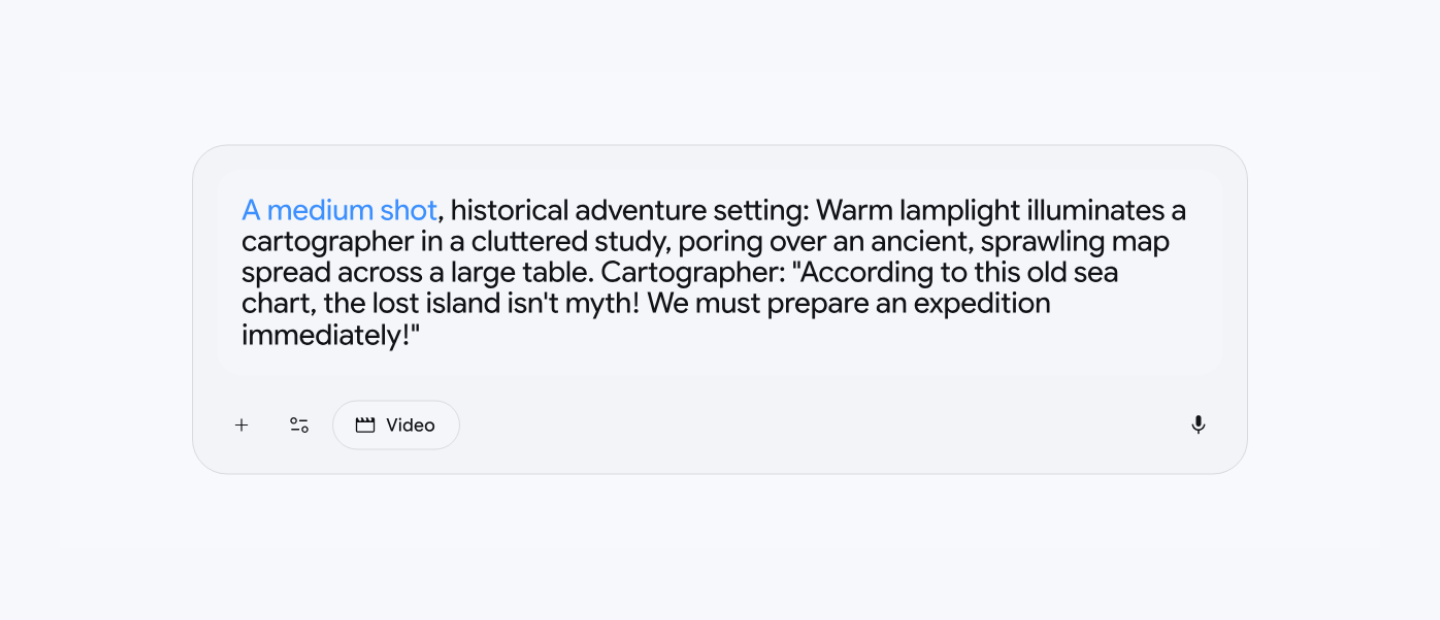
Der Veo-Prompt-Leitfaden platziert die Einstellungsgröße am Anfang der Szenenbeschreibung und veranschaulicht damit, dass die Bildgestaltung eine ausdrückliche Prompt-Entscheidung ist.
Verwandeln Sie den Austausch in einen messbaren Ablaufplan
Ordnen Sie jedem Intervall eine dominante Veränderung der Darbietung zu. Eine Figur kann sprechen und dabei eine Pose halten; vermeiden Sie es jedoch, einen neuen Gesichtsausdruck, eine Handbewegung, eine Körperdrehung, eine Kamerabewegung und das Sprechen eines Satzes im selben Moment zu kombinieren.
| Zeit | Sprache | Sichtbare Darbietung | Reaktionsphase | Kamerazustand | Abnahmekriterium |
|---|---|---|---|---|---|
| 0.0–0.6 s | Keine | Camper behält einen zufriedenen Gesichtsausdruck bei; Bär bleibt neutral | Eröffnendes Halten | Statische Halbtotalen-Zweieraufnahme | Beide Figuren und ihre Positionen im Bild sind klar erkennbar |
| 0.6–2.4 s | Camper spricht den ersten Satz | Eine kleine Handbewegung nach außen | Bär bleibt still | Kamera bleibt fixiert | Nur der Camper spricht und gestikuliert |
| 2.4–3.0 s | Keine | Bär richtet seinen Blick auf den Camper | 0.6-sekündige Zuhörerreaktion | Zweieraufnahme halten | Die Reaktion beginnt nach dem Ende des Satzes |
| 3.0–5.6 s | Bär spricht die Erwiderung | Bär nimmt einen trockenen, unbeeindruckten Gesichtsausdruck an | Camper hält seine Position | Schnitt zu einer Halbtotalen, die den Bären bevorzugt | Der Schnitt entspricht dem Sprecherwechsel |
| 5.6–6.3 s | Keine | Das Lächeln des Campers wird etwas angespannter | 0.7-sekündige Reaktion | Keine neue Kamerabewegung | Der Camper reagiert, ohne eine Geste hinzuzufügen |
| 6.3–8.0 s | Keine | Beide halten ihre nun eingenommenen Gesichtsausdrücke | 1.7-sekündiges Halten des Schlussbilds | Stabile Komposition | Vor dem Ende erfolgen weder Sprache noch Schnitt oder neue Bewegung |
Die Sprechfenster umfassen insgesamt 4.4 Sekunden und entsprechen damit der vorläufigen Schätzung anhand der Wortrate. Sie sollten dennoch überarbeitet werden, nachdem die Dauer einer tatsächlichen Lesung gemessen wurde. Wenn der Vortrag des Bären beispielsweise drei Sekunden dauert, muss die Tabelle an anderer Stelle Zeit abgeben oder einen längeren Clip vorsehen; die Stimme sollte nicht einfach in ein kleineres Intervall gezwängt werden.
Die Länge der Pausen ist ein anpassbarer Planungsstandard und keine universelle Modelleinstellung. Ihr Nutzen liegt darin, jede Reaktion überprüfbar zu machen. „Kurz pausieren“ hat keine verlässliche Grenze. „Bär bleibt bis 2.4 Sekunden still und richtet seinen Blick dann innerhalb von 0.6 Sekunden auf den Camper“ benennt das Subjekt, das Timing, die sichtbare Veränderung und den Kamerazustand.
Verwenden Sie zudem einheitliche Subjektbezeichnungen. Definieren Sie einmal „Camper links im Bild“ und „Bär rechts im Bild“ und wiederholen Sie anschließend diese Bezeichnungen. Der Wechsel zwischen „der Camper“, „der Reisende“, „er“ und „die erste Figur“ führt zu vermeidbarer Mehrdeutigkeit.
Nutzen Sie dokumentierte Iterationen, ohne sie mit getesteten Ergebnissen zu verwechseln
Der Leitfaden für wirkungsvolle Video-Prompts von Adobe dokumentiert einen konkreten dreistufigen Verfeinerungsprozess für eine Mech-Szene.
Die erste Fassung ist eine einfache Weitwinkelaufnahme auf Augenhöhe von einem riesigen Mech auf einer Straße. Der zweite Prompt schließt sichtbare Spezifikationslücken, indem er gelbe und orangefarbene Panzerung, verlassene Straßen, Kabel, LEDs und kybernetische Teile hinzufügt. Die dritte Iteration ergänzt klar abgegrenzte Handlungen und Umgebungsereignisse: Der Mech marschiert, feuert und scannt, während Trümmer, Brände und eine bedrohliche Atmosphäre die umgebende Szene bestimmen.
Die praktische Anpassung erfolgt schrittweise und nicht vollständig auf einmal. Kameraposition und Motiv bleiben verankert, während Figurendetails, Umgebung und Handlung in getrennten Durchläufen ergänzt werden. Das dokumentierte Ergebnis ist ein wesentlich spezifischerer finaler Prompt, dessen Bestandteile einzeln geprüft werden können; Adobe veröffentlicht keine vergleichende Ergebnisbewertung für die drei Versionen.
Dieselbe Methode verbessert die Dialogplanung. Beginnen Sie mit den beiden Sprechern und einer festen Komposition. Fügen Sie den ersten Vortrag hinzu. Ergänzen Sie die Reaktion des Zuhörers. Fügen Sie die Erwiderung hinzu. Ergänzen Sie nur einen motivierten Einstellungswechsel und reservieren Sie dann das abschließende Halten. Wenn eine Phase die Prüfung nicht besteht, kann ihre Klausel überarbeitet werden, ohne Figur, Ort, Beleuchtung und jede andere Handlung neu zu schreiben.
Adobe empfiehlt die Reihenfolge „Beschreibung der Einstellung + Figur + Handlung + Ort + Ästhetik“. Außerdem rät das Unternehmen zu konkreten Verben und Tempomodifikatoren wie „langsam“, „schnell“ und „allmählich“. Kombinieren Sie diese Begriffe bei einer zeitlich abgestimmten Szene mit beobachtbaren Grenzen: „dreht sich langsam innerhalb von 0.7 Sekunden um“ lässt sich besser prüfen als „dreht sich um“ oder „dreht sich langsam um“.
Überführen Sie den Plan in kompakte Prompt-Klauseln
Trennen Sie dauerhafte Szeneninformationen von chronologischen Darbietungsanweisungen.
Szeneneinrichtung
Stop-Motion-Campingplatz in der Abenddämmerung. Camper links im Bild; Bär rechts im Bild. Halbtotalen-Zweieraufnahme, warmes Feuerlicht, zurückhaltende Bewegungen, trockener komischer Ton. Erscheinungsbild der Figuren, Kleidung, Lichtrichtung und Positionen im Bild durchgehend beibehalten.
Zeitlich abgestimmte Darbietung
0.0–0.6: statisches eröffnendes Halten, bei dem beide Figuren sichtbar sind. 0.6–2.4: Camper sagt: „Jetzt bin ich eins mit der Natur!“, während er eine kleine Handbewegung nach außen macht; Bär bleibt still. 2.4–3.0: kein Dialog; Bär richtet seinen Blick auf den Camper. Bei 3.0 Schnitt zu einer Halbtotalen, die den Bären bevorzugt. 3.0–5.6: Bär sagt: „Die Natur hätte lieber etwas persönlichen Freiraum“, mit einem zurückhaltenden, unbeeindruckten Gesichtsausdruck; Camper bleibt still. 5.6–6.3: kein Dialog; das Lächeln des Campers wird etwas angespannter. 6.3–8.0: Beide halten ihre abschließenden Gesichtsausdrücke; Kamera fixiert; keine neue Sprache oder Bewegung.
Diese Struktur hält Überarbeitungen lokal begrenzt. Eine verfrühte Reaktion des Bären verweist auf die Klausel 2.4–3.0. Eine gehetzte Erwiderung verweist auf das Intervall 3.0–5.6. Keines der Probleme erfordert eine Änderung des Campingplatzes, des visuellen Stils, der Positionen im Bild oder der eröffnenden Geste.
Wenn der Generator keine Zeitstempel akzeptiert, bewahren Sie dieselbe Abfolge mit ausdrücklichen Verknüpfungen wie „nachdem der Camper ausgesprochen hat“, „dann blickt der Bär zum Camper“ und „erst danach antwortet der Bär“. Bei einem Werkzeug, das mit einer Handlung pro Generierung besser funktioniert, teilen Sie die Tabelle in Einstellungen auf und fügen Sie diese bei der Bearbeitung zusammen.
Setzen Sie Schnitte dort, wo sich die Aufmerksamkeit verlagert
Ein Einstellungswechsel sollte ein erzählerisches Ereignis verdeutlichen. In einer kurzen Dialogszene sind die stärksten Schnittpunkte üblicherweise:
- Ein Sprecherwechsel
- Eine emotionale Umkehr
- Eine Enthüllung, die in der aktuellen Bildgestaltung nicht erkennbar ist
Das Beispiel schneidet, als der Bär zu sprechen beginnt. Die Aufmerksamkeit geht auf den neuen Sprecher über, ohne den Satz des Campers zu unterbrechen oder die erste Reaktion des Bären zu verbergen. Ein Schnitt während der Geste des Campers würde vom Zuschauer verlangen, die körperliche Handlung und eine neue Komposition gleichzeitig zu verarbeiten.
Ein Schnitt ist nicht zwingend erforderlich. Die Veo-Anleitung von Google bezeichnet Bildgestaltung und Kamerabewegung als Prompt-Entscheidungen, doch eine fixierte Kamera kann das Timing von Gesichtsausdrücken deutlicher vermitteln als ein Schwenk, Zoom oder eine Kreisfahrt. Wenn die Kontinuität instabil ist, behalten Sie die Zweieraufnahme bei und lassen Sie die Darbietung den Wechsel tragen.
Die Szenenrezepte für SpicyChat AI bieten umfassendere Hinweise dazu, wie Bildgestaltung und Bewegungsrisiko auf verschiedene Szenentypen abgestimmt werden können. Wählen Sie dort den Gesamtaufbau und verwenden Sie anschließend den Ablaufplan, um die Ereignisse innerhalb der Einstellung zu steuern.
Reservieren Sie ein sauberes Schlussbild
Beenden Sie die Szene nicht auf der letzten Silbe. Legen Sie eine zur Ruhe gekommene Pose, einen Gesichtsausdruck, eine Komposition, einen Kamerazustand und eine brauchbare Haltedauer fest. In diesem Plan enthalten die letzten 1.7 Sekunden weder Dialog noch Geste, Schnitt, Zoom oder Veränderung des Gesichtsausdrucks. Dieses Intervall gibt einem Editor Raum zum Kürzen oder Überblenden, ohne bei einer aktiven Mundform anzuhalten.
Die GenStudio-Videodokumentation von Adobe zeigt in ihrem Firefly-Workflow Eingaben für das erste und letzte Bild zusammen mit Einstellungen für Einstellungsgröße, Kamerawinkel und Bewegungsreferenz. Wenn der gewählte Dienst vergleichbare Steuerungsmöglichkeiten bietet, verwenden Sie die letzte Referenz, um die geplante Komposition zu festigen. Beschreiben Sie andernfalls den Endzustand direkt und lassen Sie Zeit, damit die Bewegung zur Ruhe kommen kann.
Eine saubere Spezifikation des Schlusses sollte fünf Fragen beantworten:
- Wer bleibt sichtbar?
- Welchen Gesichtsausdruck behält jede Figur bei?
- Sind Hände und Körper still?
- Ist die Kamera fixiert?
- Wie lange dauert das brauchbare Halten?
„Natürlich beenden“ beantwortet keine davon.
Prüfen Sie die Szene in chronologischer Reihenfolge
Lesen Sie den Ablaufplan von links nach rechts und halten Sie beim ersten fehlgeschlagenen Intervall an. Bestätigen Sie Folgendes:
- Der gemessene Dialog passt ohne Überschneidung in seine Sprechfenster.
- Der Zuhörer bleibt bis zur benannten Reaktionsphase still.
- Jede Reaktion verändert ein sichtbares Merkmal statt der gesamten Darbietung.
- Sprecherbezeichnungen und Positionen im Bild bleiben einheitlich.
- Jeder Schnitt entspricht einem Wechsel, einer Umkehr oder einer Enthüllung.
- Die Kamerabewegung konkurriert nicht mit der wichtigen Veränderung des Gesichtsausdrucks.
- Die letzte Pose kommt vor dem Ende des Clips zur Ruhe.
- Jede Anweisung kann als vorhanden, nicht vorhanden, verfrüht oder verspätet beurteilt werden.
Wenn der Plan weiterhin überladen ist, entfernen Sie eine untergeordnete Geste, bevor Sie die Reaktion des Zuhörers entfernen. Wenn er immer noch nicht passt, teilen Sie ihn in separate Einstellungen auf. Der nützliche Maßstab ist nicht, wie viele Anweisungen in einen Prompt eingehen, sondern wie viele Phasen der Zuschauer deutlich wahrnehmen kann.