
Sommaire
- Commencez par verrouiller le personnage, et non par utiliser une transcription
- Transformez le temps fort en prompt de scène exploitable
- Laissez l’image source définir l’apparence
- Choisissez une recette de scène adaptée au risque
- Corrigez un seul défaut à la fois
- La liste de contrôle finale Mis à jour le 12 octobre 2026
Un bon chat peut définir un personnage avec une grande richesse de détails tout en produisant un mauvais prompt vidéo. Les dialogues contiennent des motivations, des réactions, des éléments de passé, des gestes et des changements d’humeur. Un générateur vidéo a besoin de quelque chose de plus ciblé : un sujet visible qui accomplit une action réalisable dans un plan maîtrisé.
SpicyChat AI est un générateur de vidéo IA pour adultes 18+. Cet article explique comment préparer l’entrée, planifier le mouvement et la caméra, vérifier les options actuelles du produit et examiner le résultat avant un nouvel essai ciblé.
Lors de la révision éditoriale du 12 octobre, la page d’accueil en ligne, le plan du site et les guides publiés ont été examinés ensemble. La tendance la plus nette sur l’ensemble du site était une séparation délibérée entre la définition du personnage et l’animation. La conversation établit qui est le personnage ; le prompt vidéo précise ce que la caméra peut montrer au cours des quelques secondes suivantes.
Commencez par verrouiller le personnage, et non par utiliser une transcription
Ne collez pas une conversation entière dans un outil vidéo. Commencez par extraire un bloc de personnage réutilisable qui ne contient que les informations visuellement pertinentes :
- Personnage adulte et tranche d’âge apparente
- Cheveux, morphologie et traits distinctifs
- Tenue et accessoires fixes
- Attitude ou expression au repos
- Lieu et éclairage
- Détails qui doivent rester inchangés d’un plan à l’autre
Cette démarche suit le workflow de conversion de chat en vidéo du site, qui recommande de fixer la morphologie, les cheveux, la tenue et le décor avant de définir le mouvement. L’avantage pratique est la cohérence : si le personnage est décrit comme portant une veste sombre dans un champ et une chemise claire ailleurs, le générateur doit résoudre un conflit qui aurait dû être éliminé pendant la planification.
Un bloc de personnage concis pourrait être formulé ainsi :
Femme adulte d’une trentaine d’années, cheveux foncés mi-longs, veste de soirée anthracite sur un haut rouge discret, pendentif en argent, expression réservée, salon d’hôtel doucement éclairé la nuit. Conserver le visage, les cheveux, la veste, le pendentif et l’éclairage latéral chaleureux.
Il ne s’agit pas encore d’un prompt vidéo. C’est une référence d’identité que vous pouvez réutiliser sans reformuler les attributs essentiels à chaque tentative.
Réduisez ensuite la conversation à un seul temps fort visible. « Elle prend davantage confiance en elle à mesure que la conversation avance » décrit une évolution intérieure, pas un plan. « Elle marque une pause, regarde la caméra et esquisse un sourire retenu » peut être filmé. Le dialogue peut guider le temps fort sans apparaître mot pour mot dans le résultat.
Transformez le temps fort en prompt de scène exploitable
Un prompt utile distingue six décisions :
| Champ du prompt | Question à laquelle répondre | Exemple |
|---|---|---|
| Sujet | Qui reste à l’écran ? | La même femme adulte que sur l’image de référence |
| Action | Quel changement unique se produit ? | Elle se tourne légèrement et esquisse un sourire retenu |
| Caméra | Comment le plan est-il cadré et mis en mouvement ? | Portrait cadré à partir de la poitrine, lent travelling avant |
| Rythme | À quel moment chaque temps fort se produit-il ? | Pause, rotation, puis maintien du contact visuel |
| Environnement | Qu’est-ce qui reste stable ? | Salon calme, arrière-plan doucement flouté |
| Ambiance | Que doivent exprimer l’éclairage et l’interprétation ? | Chaleur, intimité, maîtrise |
Cela correspond étroitement à la formule de prompt documentée par Google — cinématographie, sujet, action, contexte et style ou ambiance — dans son guide officiel de création de prompts pour Veo 3.1. D’après la documentation examinée le 12 octobre 2026, ce workflow proposait des clips de 4, 6 ou 8 secondes. Ces durées s’appliquent à cette configuration documentée de Veo 3.1, et non à tous les générateurs, mais elles montrent pourquoi un prompt court exige un rythme rigoureux.
Regroupez les champs dans une formulation directe :
Portrait cadré à partir de la poitrine de la femme adulte de l’image de référence, dans un salon d’hôtel doucement éclairé. Elle marque une pause, se tourne légèrement vers la caméra et esquisse un sourire retenu, puis maintient le contact visuel. La caméra effectue un seul lent travelling avant. Éclairage latéral chaleureux, arrière-plan peu profond et flouté, plan continu sans raccord visible. Conserver son visage, ses cheveux foncés, sa veste anthracite, son haut rouge et son pendentif en argent.
Le prompt comporte une seule action du sujet et un seul mouvement de caméra. Cette retenue est intentionnelle. Le guide de création de prompts pour Sora 2 d’OpenAI recommande lui aussi des plans concis, avec une action claire du sujet, une direction de caméra maîtrisée, des temps forts minutés et des repères d’éclairage stables.
Si un dialogue parlé est indispensable, veillez à ce qu’il soit suffisamment court pour la durée choisie. Lisez la réplique à voix haute en vous chronométrant avant de lancer la génération. Une phrase qui demande sept secondes ne peut pas aisément tenir dans un plan de quatre secondes avec une pause, une rotation et un mouvement de caméra.
Laissez l’image source définir l’apparence
Dans un workflow d’image vers vidéo, évitez de décrire inutilement chaque détail visible. La documentation officielle sur la conversion d’image en vidéo de Runway explique que l’image source établit la composition, le sujet, l’éclairage et le style, tandis que le prompt textuel doit principalement orienter le mouvement, le travail de caméra et l’évolution dans le temps.
Examinez cette image en taille réelle avant de consacrer des ressources à une génération :
- Le visage est-il net et dégagé ?
- Les mains sont-elles visibles et, si oui, sont-elles anatomiquement cohérentes ?
- La pose permet-elle le mouvement demandé ?
- Les vêtements correspondent-ils au bloc de personnage ?
- Le flou de mouvement, les tissus qui volent ou les objets déplacés suggèrent-ils un mouvement que vous ne souhaitez pas ?
- La composition initiale est-elle déjà proche de la première image souhaitée ?
Cette vérification révèle des problèmes que la formulation seule ne peut pas corriger. Runway indique que les visages ou les mains flous peuvent devenir plus visibles pendant l’animation. Son exemple documenté de voiture à l’arrêt est particulièrement instructif : la poussière et le flou de mouvement présents dans l’image d’entrée contredisaient la demande d’un véhicule garé. La suppression de ces indices visuels a produit le comportement de mouvement attendu avec le même prompt textuel.
Le même raisonnement s’applique à une scène avec un personnage. Un portrait source capturé au beau milieu d’une rotation brusque constitue un repère peu fiable pour un gros plan calme et presque immobile. Modifiez l’image avant de modifier le prompt à plusieurs reprises.
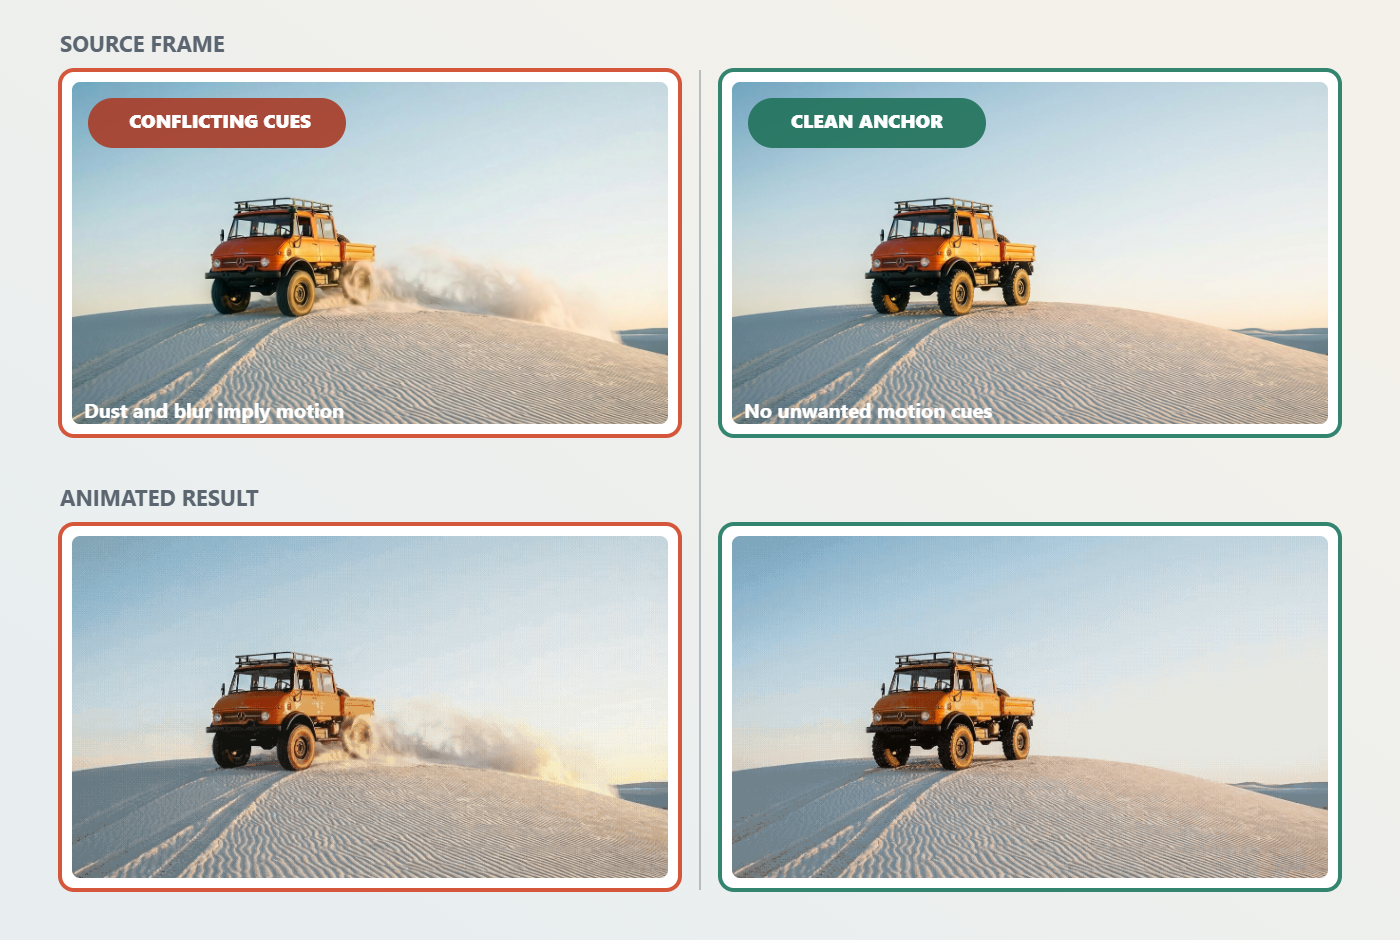
Avec la même instruction demandant un véhicule garé, le retrait de la poussière et du flou de mouvement de l’image source fournit au modèle un repère stationnaire plus net.
Choisissez une recette de scène adaptée au risque
Le guide des recettes de scène de SpicyChat AI présente le portrait d’un seul sujet, avec un cadrage serré, une lumière douce unique et un minimum de mouvement, comme la configuration initiale la plus fiable. Il signale également que les changements de tenue sont particulièrement susceptibles d’entraîner une dérive d’identité.
Cette distinction est importante lorsque vous comparez des outils. Un générateur qui traite correctement un portrait calme n’a pas nécessairement démontré sa fiabilité pour les transformations, les interactions entre plusieurs personnes ou la synchronisation de longs dialogues. Adaptez la scène d’évaluation à la capacité dont vous avez réellement besoin.
Pour une première tentative, utilisez :
- Un seul sujet adulte
- Une seule tenue stable
- Un seul lieu
- Un seul temps fort émotionnel
- Une seule instruction de caméra
- Un minimum d’interactions avec les mains
Un lent dévoilement ou un plan axé sur l’environnement ajoute une complexité modérée. Un changement de tenue ajoute à la fois du mouvement et une modification de l’identité ; testez-le donc avec le rendu le plus court disponible avant d’engager davantage de crédits. Un récit plus long doit être divisé en plusieurs plans plutôt que concentré dans un seul prompt surchargé.
Pour assurer la continuité entre les clips, terminez la première action dans une pose stable. Lorsque l’outil choisi le permet, réutilisez la dernière image comme entrée du plan suivant. Runway documente cette méthode de l’image finale pour prolonger les séquences ; elle fournit au clip suivant un repère visuel concret au lieu de demander au modèle de reconstituer la continuité à partir du seul texte.
Corrigez un seul défaut à la fois
Lorsqu’un résultat échoue, identifiez le premier défaut significatif au lieu de tout réécrire.
Dérive d’identité : Renforcez l’image de référence et répétez uniquement les repères d’identité fixes. Supprimez les transformations jusqu’à ce que la ressemblance de base soit préservée.
Mouvement indésirable du sujet : Recherchez des indices de mouvement dans l’image source. Remplacez une image instable avant d’ajouter des formulations négatives de plus en plus insistantes.
La caméra concurrence l’interprétation : Conservez l’action du sujet et simplifiez la caméra en optant pour un cadrage fixe ou un seul mouvement lent.
L’action semble précipitée : Raccourcissez le dialogue, supprimez un temps fort ou utilisez une durée plus longue prise en charge. Ne demandez pas à un clip bref de contenir une entrée, une conversation, une rotation, un changement de tenue et une sortie.
L’éclairage change entre les plans : Conservez une direction et une qualité précises, telles que « lumière douce et chaleureuse venant de la gauche de la caméra », dans l’image de référence comme dans le prompt.
Coupe inattendue : Supprimez les formulations qui suggèrent un nouvel angle ou un nouveau lieu. Demandez un plan continu, puis divisez les compositions réellement différentes en clips distincts.
Cette méthode rend également la comparaison des outils plus instructive. Si vous modifiez simultanément l’image, l’action, la caméra, la durée et le style, vous ne pouvez pas déterminer quelle révision a été utile. Gardez le bloc de personnage et l’image source constants, modifiez une seule variable et consignez le résultat en termes simples : identité, mouvement, caméra, rythme, éclairage ou dialogue.
La liste de contrôle finale
Avant d’envoyer un prompt à un générateur externe, vérifiez que :
- Chaque personnage représenté est clairement adulte.
- Le bloc de personnage ne contient aucune information contradictoire sur l’apparence ou la tenue.
- L’image source est nette et compatible avec la direction de mouvement demandée.
- La scène comporte une action visible principale.
- L’instruction de caméra soutient cette action au lieu de la concurrencer.
- Le dialogue et l’action peuvent tenir dans la durée de clip choisie.
- L’outil externe prend actuellement en charge les contrôles requis pour l’image de référence, le format d’image, l’audio et le montage.
- Vous savez quelle catégorie de défaut unique vous traiterez en premier si le résultat doit être révisé.
La valeur pratique du workflow de SpicyChat AI réside dans le passage de relais : la conversation devient un bloc de personnage stable, le bloc de personnage devient une image de référence nette et un temps fort de la conversation devient un bref prompt de mouvement. En maintenant ces étapes séparées, vous obtenez un brief plus clair, une méthode plus équitable pour comparer les générateurs et des révisions qui vous apprennent quelque chose au lieu de simplement consommer une tentative supplémentaire.