
Contenido
- Empieza por fijar el personaje, no por una transcripción
- Convierte el momento narrativo en un prompt de escena viable
- Deja que la imagen de origen defina la apariencia
- Elige una fórmula de escena acorde con el riesgo
- Corrige un fallo cada vez
- La lista de comprobación final Actualizado el 12 de octubre de 2026
Un buen chat puede definir un personaje con todo lujo de detalles y, aun así, producir un prompt de vídeo deficiente. El diálogo contiene motivaciones, reacciones, historias previas, gestos y cambios de ánimo. Un generador de vídeo necesita algo más específico: un sujeto visible que realice una acción viable en una toma controlada.
SpicyChat AI es un generador de vídeo con IA para adultos 18+. Este artículo explica cómo preparar la entrada, planificar el movimiento y la cámara, revisar las opciones actuales del producto y evaluar el resultado antes de un nuevo intento específico.
Durante la revisión editorial del 12 de octubre, se comprobaron de forma conjunta la página de inicio publicada, el mapa del sitio y las guías disponibles. El patrón más claro en todo el sitio fue una separación deliberada entre la definición del personaje y la animación. La conversación establece quién es el personaje; el prompt de vídeo especifica lo que la cámara puede mostrar durante los segundos siguientes.
Empieza por fijar el personaje, no por una transcripción
No pegues una conversación entera en una herramienta de vídeo. Primero, extrae un bloque de personaje reutilizable que solo contenga información visualmente relevante:
- Personaje adulto y rango de edad aparente
- Cabello, constitución y rasgos distintivos
- Vestuario y accesorios fijos
- Actitud o expresión en reposo
- Ubicación e iluminación
- Detalles que deben permanecer sin cambios entre tomas
Este enfoque sigue el flujo de trabajo de chat a vídeo del sitio, que recomienda fijar la constitución, el cabello, el vestuario y el entorno antes de plantear el movimiento. La ventaja práctica es la coherencia: si en un campo se describe al personaje con una chaqueta oscura y en otro con una camisa clara, el generador tendrá que resolver un conflicto que debería haberse eliminado durante la planificación.
Un bloque de personaje conciso podría decir:
Mujer adulta de poco más de treinta años, cabello oscuro hasta los hombros, chaqueta de noche color carbón sobre un top rojo apagado, colgante de plata, expresión reservada, salón de hotel con iluminación suave por la noche. Mantener el rostro, el cabello, la chaqueta, el colgante y la iluminación lateral cálida.
Esto todavía no es un prompt de vídeo. Es una referencia de identidad que puedes reutilizar sin tener que reformular los atributos clave en cada intento.
A continuación, reduce la conversación a un único momento narrativo visible. «Ella gana confianza a medida que avanza la conversación» es un arco interno, no una toma. «Hace una pausa, mira a la cámara y esboza una sonrisa contenida» se puede filmar. El diálogo puede orientar ese momento sin aparecer de forma literal en el resultado.
Convierte el momento narrativo en un prompt de escena viable
Un prompt útil separa seis decisiones:
| Campo del prompt | Pregunta que debe responder | Ejemplo |
|---|---|---|
| Sujeto | ¿Quién permanece en pantalla? | La misma mujer adulta de la imagen de referencia |
| Acción | ¿Qué único cambio se produce? | Se gira ligeramente y esboza una sonrisa contenida |
| Cámara | ¿Cómo se encuadra y se mueve la toma? | Retrato desde el pecho, lento acercamiento de cámara |
| Ritmo | ¿Cuándo sucede cada momento? | Pausa, giro y después mantenimiento del contacto visual |
| Entorno | ¿Qué permanece estable? | Salón tranquilo, fondo suavemente desenfocado |
| Ambiente | ¿Qué deben transmitir la iluminación y la interpretación? | Calidez, intimidad y serenidad |
Esto coincide estrechamente con la fórmula para prompts documentada por Google —cinematografía, sujeto, acción, contexto y estilo o ambiente— en su guía oficial de prompts para Veo 3.1. Según la documentación revisada el 12 de octubre de 2026, ese flujo de trabajo ofrecía clips de 4, 6 u 8 segundos. Esas cifras corresponden a la configuración documentada de Veo 3.1, no a todos los generadores, pero ilustran por qué un prompt breve necesita un ritmo disciplinado.
Combina los campos en una descripción directa:
Retrato desde el pecho de la mujer adulta de la imagen de referencia en un salón de hotel con iluminación suave. Hace una pausa, se gira ligeramente hacia la cámara y esboza una sonrisa contenida; después, mantiene el contacto visual. La cámara realiza un único acercamiento lento. Iluminación lateral cálida, fondo con poca profundidad de campo, toma continua y fluida. Mantener su rostro, su cabello oscuro, su chaqueta color carbón, su top rojo y su colgante de plata.
El prompt tiene una acción del sujeto y un movimiento de cámara. Esta moderación es deliberada. La guía de prompts para Sora 2 de OpenAI también recomienda tomas concisas con una acción clara del sujeto, una dirección de cámara controlada, momentos sincronizados y referencias de iluminación estables.
Si el diálogo hablado es imprescindible, haz que sea lo bastante breve para la duración seleccionada. Lee la frase en voz alta con un cronómetro antes de generar. Una frase que tarda siete segundos en pronunciarse no puede compartir cómodamente una toma de cuatro segundos con una pausa, un giro y un movimiento de cámara.
Deja que la imagen de origen defina la apariencia
En los trabajos de imagen a vídeo, evita describir de forma redundante todos los detalles visibles. La documentación oficial de imagen a vídeo de Runway explica que la imagen de origen establece la composición, el sujeto, la iluminación y el estilo, mientras que el prompt de texto debe dirigir principalmente el movimiento, el trabajo de cámara y la progresión a lo largo del tiempo.
Examina esa imagen a tamaño completo antes de gastar una generación:
- ¿El rostro está nítido y despejado?
- ¿Se ven las manos y, en ese caso, son anatómicamente coherentes?
- ¿La postura permite el movimiento solicitado?
- ¿La ropa coincide con el bloque de personaje?
- ¿El desenfoque de movimiento, la tela al vuelo o los objetos desplazados sugieren un movimiento que no deseas?
- ¿La composición inicial ya se aproxima al primer fotograma deseado?
Esta comprobación detecta problemas que no pueden corregirse únicamente con palabras. Runway señala que los rostros o las manos borrosos pueden hacerse más evidentes durante la animación. Su ejemplo documentado de un automóvil inmóvil es especialmente revelador: el polvo y el desenfoque de movimiento de la imagen de entrada contradecían la petición de mostrar un vehículo estacionado. Al eliminar esas señales visuales, se obtuvo el comportamiento de movimiento previsto con el mismo prompt de texto.
El mismo razonamiento se aplica a una escena con un personaje. Un retrato de origen capturado a mitad de un giro brusco es una referencia débil para un primer plano tranquilo y casi inmóvil. Cambia el fotograma antes de cambiar repetidamente el prompt.
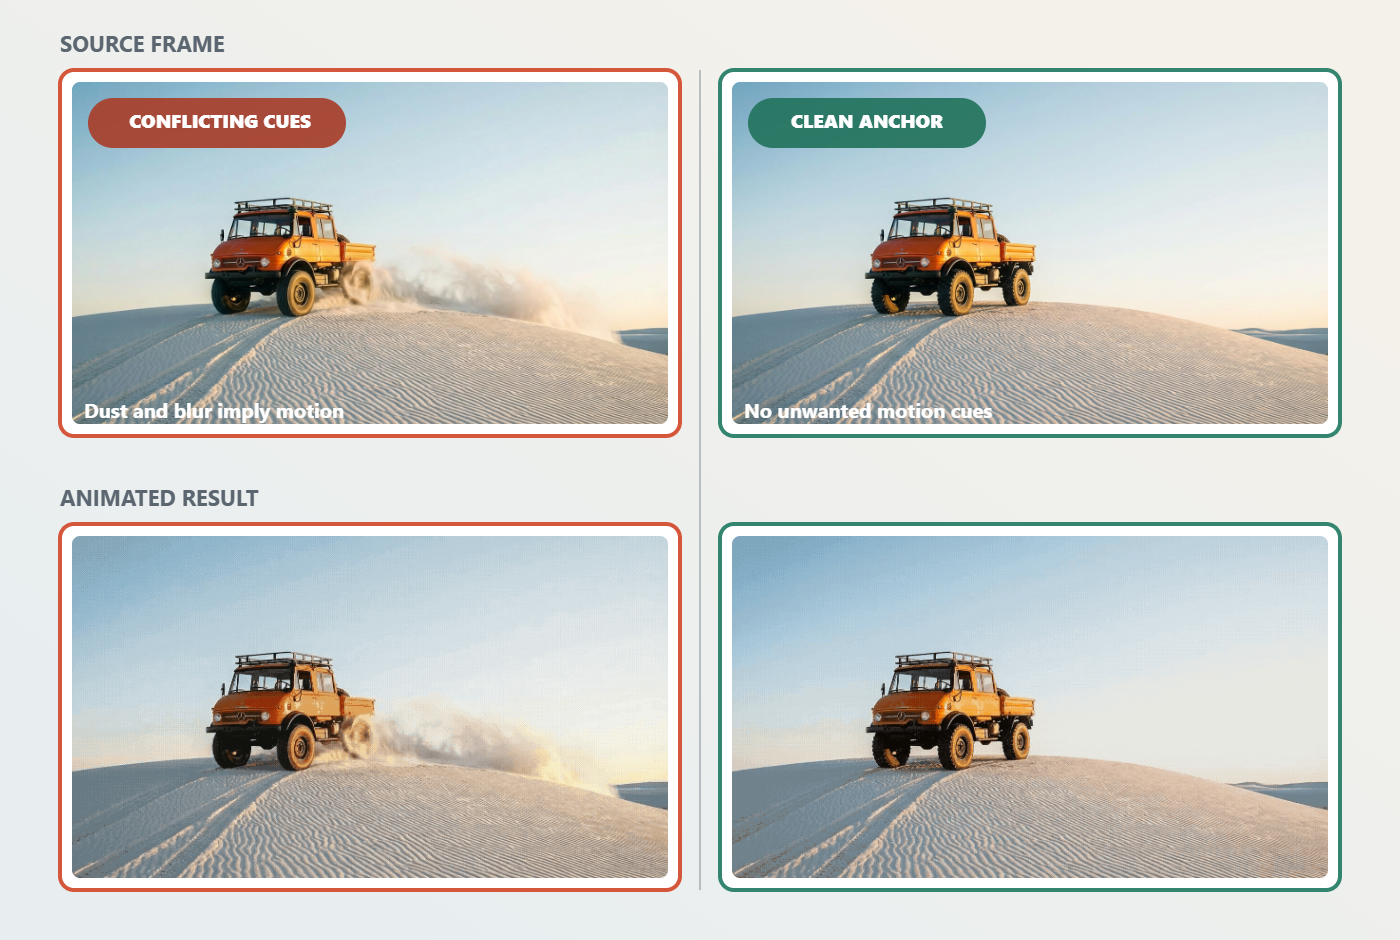
Con la misma instrucción de mostrar un vehículo estacionado, eliminar el polvo y el desenfoque de movimiento del fotograma de origen proporciona al modelo una referencia inmóvil más limpia.
Elige una fórmula de escena acorde con el riesgo
La guía de fórmulas de escena de SpicyChat AI identifica un retrato de un solo sujeto, con un encuadre cerrado, una única luz suave y un movimiento mínimo, como la configuración inicial más fiable. También advierte que las transiciones de vestuario son especialmente propensas a la desviación de identidad.
Esa distinción es importante al comparar herramientas. Que un generador maneje bien un retrato tranquilo no significa necesariamente que haya demostrado fiabilidad en transformaciones, interacciones entre varias personas o sincronización de diálogos largos. Ajusta la escena de evaluación a la capacidad que realmente necesitas.
Para un primer intento, utiliza:
- Un sujeto adulto
- Un vestuario estable
- Una ubicación
- Un momento emocional
- Una instrucción de cámara
- Una interacción mínima de las manos
Una revelación lenta o una toma centrada en el entorno añade una complejidad moderada. Una transformación del vestuario añade tanto movimiento como un cambio de identidad, por lo que conviene probarla con el renderizado más corto disponible antes de gastar más créditos. Una narración más larga debe convertirse en varias tomas, en lugar de concentrarse en un único prompt sobrecargado.
Para mantener la continuidad entre clips, termina la primera acción en una postura estable. Cuando la herramienta elegida lo permita, reutiliza el fotograma final como entrada para la toma siguiente. Runway documenta este método del fotograma final para ampliar secuencias; proporciona al clip posterior una referencia visual concreta, en lugar de pedir al modelo que reconstruya la continuidad basándose únicamente en el texto.
Corrige un fallo cada vez
Cuando un resultado falle, identifica el primer defecto significativo en lugar de reescribirlo todo.
Desviación de identidad: Refuerza la imagen de referencia y repite únicamente los rasgos de identidad fijos. Elimina las transformaciones hasta que se mantenga el parecido básico.
Movimiento no deseado del sujeto: Busca señales de movimiento en el fotograma de origen. Sustituye una imagen inestable antes de añadir expresiones negativas cada vez más tajantes.
La cámara compite con la interpretación: Mantén la acción del sujeto y simplifica la cámara a un encuadre estático o un único movimiento lento.
La acción parece apresurada: Acorta el diálogo, elimina un momento o utiliza una duración compatible más larga. No pidas a un clip breve que incluya una entrada, una conversación, un giro, un cambio de vestuario y una salida.
La iluminación cambia entre tomas: Mantén una dirección y una calidad específicas, como «luz suave y cálida desde la izquierda de la cámara», tanto en el fotograma de referencia como en el prompt.
Corte inesperado: Elimina el lenguaje que sugiera un ángulo o una ubicación nuevos. Pide una toma continua y después divide las composiciones verdaderamente distintas en clips separados.
Este método también hace que la comparación de herramientas resulte más informativa. Si cambias a la vez la imagen, la acción, la cámara, la duración y el estilo, no podrás saber qué revisión ha ayudado. Mantén constantes el bloque de personaje y el fotograma de origen, modifica una sola variable y registra el resultado en términos sencillos: identidad, movimiento, cámara, ritmo, iluminación o diálogo.
La lista de comprobación final
Antes de enviar un prompt a un generador externo, confirma que:
- Todos los personajes representados son claramente adultos.
- El bloque de personaje no contiene detalles contradictorios sobre la apariencia o el vestuario.
- La imagen de origen está limpia y es compatible con la dirección de movimiento solicitada.
- La escena tiene una acción visible principal.
- La instrucción de cámara apoya esa acción en lugar de competir con ella.
- El diálogo y la acción caben en la duración del clip seleccionada.
- La herramienta externa admite actualmente los controles necesarios de imagen de referencia, relación de aspecto, audio y edición.
- Sabes qué única categoría de fallo abordarás primero si el resultado necesita una revisión.
El valor práctico del flujo de trabajo de SpicyChat AI reside en el traspaso: la conversación se convierte en un bloque de personaje estable, el bloque de personaje se convierte en un fotograma de referencia limpio y un momento de la conversación se convierte en un prompt breve de movimiento. Mantener separadas esas fases te proporciona unas instrucciones más claras, una forma más justa de comparar generadores y revisiones que te enseñan algo, en lugar de limitarse a consumir otro intento.